跳到主要内容

MoeCTF 2026 比赛运维记录

· 阅读需 18 分钟
林林
在西安读大二的小菜鸡

杭电 HGame 两年都有运维的记录,一是HGAME 2026 运维秘话,二是从 HGAME2025 运维,聊聊学校战队 CTF 独立办赛。MoeCTF 2026 算是我运维的第二场 CTF 比赛,第一场是一个项目的新年小活动。

作为协会的运维,平常更多的是拿开源的项目搭建一个文档之类的服务出来给协会的同学用。比赛平台有学院的学长负责,服务器资源也够办赛,所以相比于杭电的比赛运维来说,我这个运维就水多了。综上,我在比赛当中的角色更像是一个筹备的策划,或者说是一个项目经理,每天对着筹备安排的时间表来推进任务。(之前测了一项程序员性格测试,荣获“开会型程序员”称号)

总述​

这篇文章都是我自己的想法,不能代表什么。

本场比赛的数据如下:

  • 4455个报名队伍
  • 149个公开题目
  • 83625次提交,52685次正确提交
  • 复旦大学、中国人民公安大学、江南大学、南京邮电大学、吉林大学、河南大学、西南交通大学和郑州轻工业大学等高校的协会或战队参与比赛的协办

我觉得今年做得不好的地方:

  • 题目难度把控不够到位,有些题放到miniL里也毫不逊色
  • 虽然今年有“从此开始”,逆向的入门做得挺好,但总体的新手引导还有待改进

我觉得我在工作中犯的错误:

  • 做事之前缺少商量,对发公告的影响考虑不周
  • 在组织这场比赛的过程中很多取舍有待商榷
  • 活都被我自己干完了

回顾这次组织的经历,以及查看部分选手填写的问卷,今年有哪些东西在我看来值得后面的MoeCTF学习(给后面比赛的一些建议):

  • 开“从此开始”方向,配套视频,讲搜索引擎、IDE的使用等
  • 在题目中用标签标明考点,比如SQL注入等

每年的MoeCTF都有点像是摸着石头过河,尽管我在筹备时就看完学长办之前比赛的复盘总结,并将其奉为圭臬,还是踩了不少的坑,犯了不少错误。

报名前​

在比赛开始报名(2026-08-02)之前,我大概做了这些工作:

  • 用 Docmost 搭了一个在线文档,供比赛筹备的各位同学进行协作,后面发现 Outline 好像更好用一点,就迁移到 Outline 了
  • 在平台上创建比赛、设置比赛,给 SandBox 进行重复性劳动(弄了很多题的环境)
  • 反复阅读协会往年办 moe 的经验教训总结,生怕有些坑掉进去了
  • 写了一点点关于非预期解、无解之类的预案
  • 用 Deepseek + Claude Code 重构原本的比赛 QQ 机器人代码,跟协办高校对接校内群
  • 录了一下环境的使用视频、入门视频
  • 盯着筹备文档的时间安排,push 自己和同学

虽然反复阅读往年比赛的复盘,但自己认为这个阶段中还是有做的不好的地方,还有今年的一些新情况:

  • 学院公众号的推文发太早了:去年的学院推文是 8月1号 发的,今年原本打算推迟到 8月2-4号,但 7 月下旬支教的时候趁着有空把推文写了发给会长,7月22号推文就发出来了。现在挺担心比赛对新生的宣传效果的,毕竟一些省份普通类录取结果还处于 没出 / 刚出 的状态,感觉估计没啥 xdx 关注学院公众号……以往不可谏,来者犹可追。看来后面投稿对策府库和校园墙的时候要慢一点、稳一点,然后妥善安排一下对学院新生群的推广以及9月中上旬的中期复盘推文。
  • 大家出题热情高涨:先前的时间表估计都是基于大家没啥出题热情来设计的,但今年到了7月中旬就已经出了快一百题了,据学长说往年这个时候连十题都还没有。时间安排有点早,导致现在7月下旬大家都没有安排了。一些同学原本打算7月下旬再开始着手准备的,但现在活都被刨干净了……
  • 协办高校参与出题:今年有三位来自复旦六星战队的同学参与出题,据学长说这同样是往年没有的情况。

就本阶段的一些做法发表我自己的意见:

选手群为什么要禁止卖弱慕强?
答:MoeCTF 作为一个标榜新手友好的比赛,如果选手群里都是“弱弱”“大佬求带”“?!强强!?”这些话,又或者是用k8s搭建自部署服务遇到个问题求解决这些技术炫技,我作为新手肯定是不敢说话的。比赛筹备群里也有对这件事进行讨论,有些学长认为“群里有技术讨论其实是好事”,但过于高深的讨论,或者说有时候是技术炫技反而会吓到新手,这些高深的技术问题不乏硬核的群聊可以寻求帮助,但在新生群里说这些,预期就不是要讨论,而是宣称“嘿嘿给你们看看我在做这个”。往年的复盘提到维护选手群的氛围是一件既重要又困难的事情,这个估计是报名后、开赛后工作的重点之一。

报名及比赛​

这个阶段没发生什么情况,基本在选手群内引导平台的使用等等。比赛开始前几天进行题目的互相验题,总体来说没出现太大的问题。这个互相验题还是有必要的,比如运维题的入门指北复仇,rx学长就找到了一个非预期路径。

在这个阶段中有一些情况:

  • 签到题和AI题在评测脚本设置这一块出现问题,选手弄出了答案发现不对,都采用改为静态flag的方式解决,week2的AI题没有这个情况。
  • 外部环境部署的长亭雷池起了作用,防住了很多不友好的流量,雷池的等待室功能也能削峰,避免服务被冲烂。
  • 在比赛开始的第一天,我们对疑似 AI 做题的选手进行了隐藏。
  • 有些时候的出题、验题安排不够好。
  • 在临近比赛结束的时候,部分选手在自己的博客、GitHub等公开平台发布自己的WriteUp。

今年我们在“从此开始”方向当中弄了一些让选手熟悉环境连接的题目,并录制了关于连接题目环境的操作视频,今年问环境怎么连的估计比去年少,但还不少。

为什么评测脚本会有问题?验题的时候没验出来吗?
答:平台默认的评测脚本会根据队伍id或用户id生成flag。选手既有队伍id,又有用户id,按照下面代码的逻辑会优先取队伍id。而管理员只有用户id,临时身份识别码取到的也是用户id,所以管理员验题的时候没有问题,选手拿着通过用户id生成的flag到平台一交就有问题了。至于为什么刚开始一些选手能提交?因为他们的用户id和队伍id相同。后面是怎么解决的?后面的ai题都改成输入队伍密钥进行认证,获取到的就是队伍id了。

let enc_id = if let Some(id) = team.id {
id
} else {
user.id
};

由于这次外部环境比较多,动态flag生成的逻辑写了好几次,比较烦。正所谓“一次写,二次抄,三次开始就抽象”,把平台默认的动态flag生成逻辑封装成一个Python库。后面办赛如果要用到外部环境就可以直接用了。

from ret2shell_kit import Ret2ShellClient, LeetStego

with Ret2ShellClient("https://ctf.xidian.edu.cn/api") as client:
team = client.game.find_team_by_team_code(37, "xxxxxxxxxxxx")
print(team.id) # id

stego = LeetStego("your_secret_key")
template = "this-is-an-example"
data_id = 12345
encoded = stego.encode(template, data_id)
print(f"编码结果 {encoded}")

外部环境的服务前期时不时崩溃,是为什么?
答:本次比赛外部环境的链路是这样的,长亭雷池和题目环境部署在不同的服务器上,长亭雷池跟我的博客一起挤一挤,题目环境放在协会的服务器。

这样做有几点好处:

  • 让 ESA 和 WAF 把一些恶意流量挡在协会服务器外面
  • 当遇到泛洪等流量攻击,崩溃的是我自己的服务器,运行着推送机器人等重要业务的协会服务器不受影响
  • ESA 回源 IP 比较多,这样做可以更方便地设置协会服务器的安全组

但是这也伴随着一些问题:我自己的博客服务器配置并不高,内存只有2GB,上面还部署着 MariaDB、Redis、php-fpm 之类比较吃内存的服务,更何况长亭雷池本身就非常需要内存。雷池经常会跟其他服务抢内存,出现内存溢出。原先想着要不设置 swap 分区试试,结果没用,内存没空出多少,磁盘性能先吃满了。其实直接升配是最简单的解决办法,但我一看我的钱包,还是算了。把我的博客,以及上面那些服务一扬,就有内存给雷池了。

七夕节的AI限定题目为什么一拖再拖?
答:我感觉我和 misc 出题的几位算本次比赛最抗压的了。这个限定题目计划在情人节下午 5 点 20 分发布,但下午 1 点左右才弄出一个初步的版本,等我醒来并把这个题目部署上去已经下午 3 点了。大家低估了这道题目的复杂性,那 AI 写的代码过于抽象(字面意义,动不动就拆出来一个函数或者类),AI 都改不好这个代码。除了改题的难度之外,验题也需要一点心思,毕竟这个flag的触发条件有点苛刻了。

本次比赛AI题花了多少钱嘞?
答:见下表。

项目金额 CNY合计 CNY
deepseek api 按消耗金额开票73.96
opencode go 20260808-090833.57
超算互联网大模型api18.16
opencode go 20260906-100667.53193.22

这次办赛AI题用opencode的“月租”套餐。办赛过程中由于选手做七夕限定题目的热情超出预期,套餐被刷光了,所以当晚改用Deepseek官方的API,尽管服务比较稳定,时延低,但造成了较多的开销。

后面改用国算比较便宜的Deepseek旧版模型,并对选手的对话进行审计,发现一些选手真的跟AI聊上天了。比如说:

  • 最最最喜欢七夏了!
  • 回你家还是回我家
  • 我们要不要去看星星
  • 我草这个flag怎么那么难拿
  • 等等……

AI题目遇到的主要困扰是:如果让AI给flag的话,会因为幻觉出现给假flag的问题。解决方法可能就是像七夕限定题目那样,AI负责判断该不该给flag,然后由题目环境显示flag。

QQ机器人和比赛平台运维过程中有什么值得说的事情?
答:QQ机器人通过接入比赛平台“消息推送”的WebSocket接口进行信息获取,之前已经有成型且经过检验的代码,但所有的东西(包括跟比赛平台、Napcat收发信息等)都在同一个文件里。用cc + Deepseek对代码进行模块化和重构,并将前三血的推送消息从纯文本改成图片。比赛机器人也为协办高校提供推送,设置了一个字典(如下),支持了多个院校,以及院校可以开设分群,后续moe如果有其他高校参与可以很方便地修改和移植。

MATCH_CTF_INTERNAL_GROUPS = {
"西安电子科技大学": [114514],
"复旦大学": [114524],
}

比赛过程中进行了两次平台更新,第一次跟学长和已有的SOP更新(升级的时候没注意,把main分支的开发版推上去了,回退成release时数据库迁移脚本报错,就又再撤成开发版,在更新之前没有跟开发沟通好),第二次自己做了一下。后面应该可以胜任这种更新工作。第二次更新时,平台新增了里程碑功能,我们第一时间对moe的题目进行了设置。现在我应该可以自己按照SOP独立进行平台的升级了。

比赛过程中,平台接入了郑州某大学的统一身份验证,在对接的过程中发现平台的机器访问公网要向学校开点对点的连接,对面cas返回的数据没有cas:cn,平台原先的rune运行会崩溃,向平台仓库推送了一下修改。

设置里程碑的过程中有什么考虑,有何得失?
答:里程碑功能允许我们对选手的做题顺序进行强制规定。目前的调整是:大部分题目要求先做完“从此开始”和“入门指北”,有一些题目之间有前置关系,需要规定做题顺序。相比于做某道题目做一半发现需要另外一道题目里面用到的知识,刚学会1+1=2就来做微积分,“这个题目以后再来探索吧”给选手体验带来的影响可以忽略。在有里程碑这个功能之前,我们原先预想“从此开始”方向这个名字应该能让选手选择作为第一个方向做,但实践中不乏做“策略与博弈”问临时身份识别码怎么拿(签到题里有写),做Web题问题目环境怎么连(从此开始2-1、2-2、2-3分别讲了wsrx、nc和ssh的用法),让我们不能指望选手都能按照我们的意愿来。

在这个过程中,我个人的工作也出现了问题。将“二进制漏洞利用”出题人推荐的顺序弄成强制顺序,后面做了修改。

比赛后期如何处理选手公开的题解?
比赛后期出现了多位选手提交同一个选手的flag,平台报告的作弊事件比前期更频繁。我们起初怀疑有人公开了自己的flag,经协办高校负责人的询问和出题人的调查,发现以下情况:

  • 有一位选手将自己的flag公开在Gitee平台上,另一位选手A在做题过程中使用AI,AI将抓取到的仓库内容呈现到回答里,选手直接使用了flag,导致作弊。
  • 有一位选手将自己的题解公开在博客上,并附自己的flag。另一位选手B在做题过程中搜索到了博客,并直接使用该flag,导致作弊。

我们对以上在比赛结束前公开题解的选手处封禁队伍+封禁账号处罚。选手A的行为其实为未规范使用AI,改为隐藏队伍;选手B经过我们跟协办高校的沟通,仍保持封禁队伍,协办高校将拒绝其加入校队。

关于公网上一些没有跟作弊关联的题解,我们通过联系作者撤回文章。不对作者做类似封禁等的处理,因为MoeCTF本身其实是一个引导新生入门的“比赛”,如果没有什么影响,单单提前发布题解就封禁队伍和账号,未免“一刀切”和不讲人情。

在比赛一开始,我们就在咸鱼上发现了贩卖MoeCTF 2026题解的商品。他们并不直接提供答案,而是给题解,教买家做题。我们也在某公开的AI聊天网站中看到有人直接将misc方向某题的附件直接丢给AI得到答案,也有人让AI写小作文谴责嘲讽misc方向的某位出题人。给题解这件事虽然让人感到愤怒,但给题解跟着题解做大概就能理解,我们这些为爱发电出的题还能卖到5块钱呢。

关于AI的态度
感觉ctf圈子里面已经兴起一种AI的狂欢。我没有什么深入的技术,也不好评价古法和AI的优劣。但就新生赛而言,用AI做题完全没有意义。我们最开始通过答题的时间间隔来判断AI,后面摆了,直到发现了这么一道题目——“C语言环境配置与基础语法”。

直接获取本题flag?看看这段C语言代码,执行它?好像代码有点问题,改一改吧,然后执行就可以得到flag。

#include <studio.h>

int main() {
unsigned char encrypted[] = "8:06!3.6x<&x4x34&!x4;1x=<2=x90#09x94;2 420(";
unsigned char key = 0x55;
for(int i = 0; encrypted[i]; i++) {
encrypted[i] ^= key;
}
printf("%s\n", encrypted);
return 0;
}

这道题简直太适合用来抓直接喂给AI获取答案的选手了,因为AI幻觉的原因(AI很有可能不会亲自执行代码),有些选手提交了一些离谱的答案,比如:

  • flag{C_L4ngu4g3_1s_v3ry_funny!!!}
  • moectf{C_l4ngu4g3_f0r_100p_3rr0r_1s_v3ry_e4sy}
  • flag{1_h0p3_y0u_l1k3_c_pr0gr4mm1ng}
  • moectf{X0r_1s_s0_e4sy_7h1ngs}

前两个还好,最后一个估计看到用了异或直接编了一个xor的flag了。太明显了。我们后面主要对这些提交进行处理。

招新与面试​

原本打算招新公告9月15日再发的,但9月10日的时候已经有xdx通过搜索引擎发现了,就直接发出来让大家注册。

招新系统今年有什么问题,怎么解决,有哪些问题还留着?

  • “简历”太正经——改成“个人介绍”
  • 缺少更全面的筛选功能,有些危险操作缺少额外确认——让AI加上
  • 向所有面试者展示面试状态和通过方向——删

大伙对今年招新系统的评价有点像毛坯房,开发的时候提不出什么意见,实际用起来问题一堆。

百团大战(社团联合招新)的开展情况如何?

今年百团的时间比较神秘,大家都颇有微词。两天都在上课,时不时还下雨,也指不定谁有空,原本想要排班就没排。把协会的大显示屏拉过去,第一天用显示屏展示PPT和长亭的防护大屏,第二天才用ubuntu弄好钓鱼Wi-Fi演示。有挺多同学通过百团大战了解我们协会,效果不错。

一面二面总体情况如何?

这次招新总体上还是不错的,有很多对安全感兴趣的同学加入进来,这当中有一些活跃、实力不错的同学。今年在学院公众号、对策府库等等都发布了比赛的信息,在新生晚点名做了一下宣讲,整体宣传的效果还行。如前述内容,招新系统在体验上存在问题。邮件发送方面,每年发送招新邮件都会因为zoho的限频而出现问题,今年也发生了限频,换邮件服务提供商这件事情很早就提过,但一直没有落实。今年趁这个机会改换为飞书,希望以后不会有这个“固定节目”了。

开发运维部面试的任务就是用自己擅长的语言写一个2048小游戏,面试过程中考察同学对自己编写代码的熟悉程度,让他们介绍自己是怎么处理游戏过程中数据变动的逻辑的。今年招进了6位,拒绝了1位。人多活少。就看后面怎么安排了,让加入开发运维部的同学都有所收获,也让自己轻松一点。(我当年哪有这条件啊)

致谢​

首先感谢学部的支持,没有学部,我们几乎不可能办成这场比赛。感谢各个方向出题的同学们和学长,他们愿意在这件事情上付出精力。感谢长亭雷池提供的waf专业版,要是没有waf拦着,这场比赛的外部环境估计就被冲烂了。

最后,我的母亲虽然不了解我们在做什么,但她大概知道我们在办一场给新生的比赛,每隔一段时间就会问一下比赛结束了没有。当学院公众号发布有关比赛的文章时,她第一时间看到并推荐。

谈谈认证

· 阅读需 18 分钟
林林
在西安读大二的小菜鸡

HTTP是一个无状态的协议,但Web服务又需要认出访客(比如登录等功能),这两者就产生了一个矛盾。为了解决这个矛盾,前人想出了一些认证的办法,来证明“我是我,你是你”。

HTTP Basic Auth​

HTTP状态码中有一个401 unauthorized状态码,服务端用来告诉客户端“未验证”,并在WWW-Authenticate头告诉客户端应该进行何种验证。Basic Auth算是验证方式最简单的一种。

我们用Flask构建一个要求basic验证的服务。

from flask import Flask, render_template
from flask_basicauth import BasicAuth

app = Flask(__name__)

app.config['BASIC_AUTH_USERNAME'] = 'example'
app.config['BASIC_AUTH_PASSWORD'] = 'foo'

basic_auth = BasicAuth(app)

@app.route('/secret')
@basic_auth.required
def secret_view():
return render_template('secret.html')

if __name__ == "__main__":
app.run()

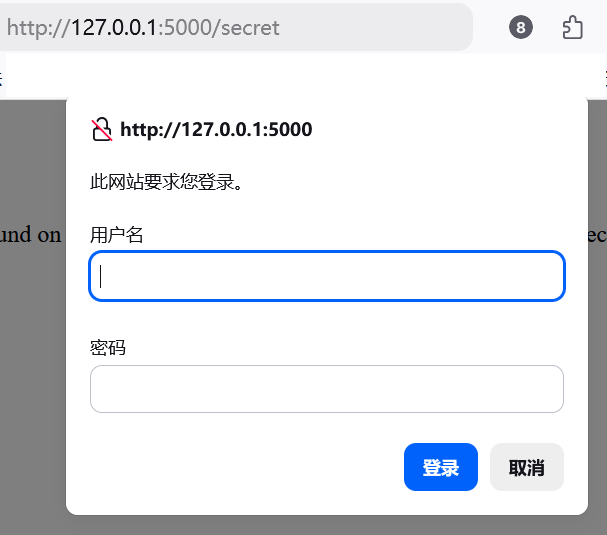
当我们访问/secret这个路由时,浏览器会跳出输入框让我们输入用户名和密码(严格来说是口令),当我们输入完example和foo后,secret.html就渲染出来了。

basic-auth-1

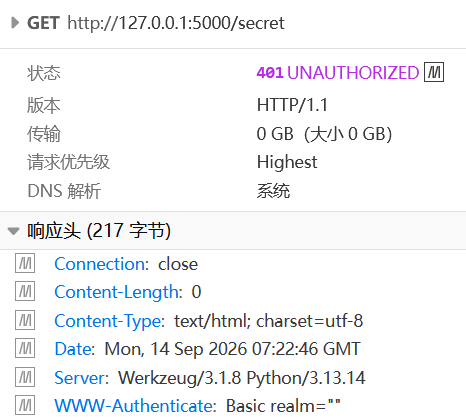
可以看到刚才的鉴权页面服务器给浏览器发送了一个401状态码,和WWW-Authenticate: Basic realm=""头,这跟我们刚才的描述一样。它告诉浏览器要用Basic Auth进行身份验证。这里的realm有什么用呢?它描述受保护区域的字符串。realm允许服务器对它受保护的区域进行区分(如果允许支持这种划分方案),并通知用户需要哪个特定的用户名/密码。如果未指定 realm,客户端通常会显示格式化的主机名。1Emm,感觉不太会用到。但这个字段又是必须的(参见 RFC7235 第2.2节,但 MDN 又标明这个字段是可选的)。

basic-auth-challenge-header

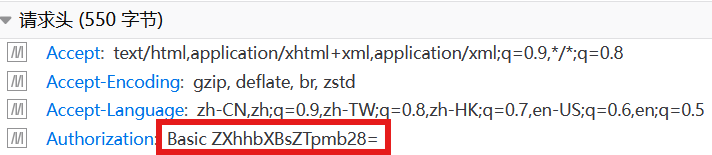
我们可以看到浏览器在请求这个页面的时候在Authorization里面加了一个Basic ZXhhbXBsZTpmb28=,Basic代表使用的鉴权方式是Basic Auth,后面那个字符串是一个base64编码。解码之后得到example:foo,也就是username:passwd。

basic-auth-2

浏览器有时会重用之前的验证信息,这样就不用每次都验证了。比如在http://example.com/docs/index.html经过的身份验证,访问http://example.com/docs/、http://example.com/docs/test.doc和http://example.com/docs/?page=1时浏览器会自动发送先前的Authorization Header,而http://example.com/other/和https://example.com/docs/不会发送,需要重新验证。(参见 RFC 7617 2.2. Reusing Credentials)

Basic Auth最大的安全漏洞在于对密码进行明文传输(尽管经过了base64编码,但跟明文无异),所以Basic Auth通常需要配合HTTPS使用。这种验证方式还不防重放(Replay Attack)。现在很少见有服务采用这种验证方式。

Digest Auth​

Digest Auth只用摘要值来验证身份,不用明文传输密码,还可以防重放。我们实现一个最简单的应用。

from flask import Flask, request, redirect, render_template
from flask_digest_auth import DigestAuth, make_password_hash

app = Flask(__name__)
app.config['SECRET_KEY'] = 'foo-secret-key'
auth: DigestAuth = DigestAuth("secret-path")

users = {}
users['admin'] = make_password_hash("secret-path", 'admin', '123456')

@auth.register_get_password
def get_password_hash(username):
return users.get(username)

@auth.register_get_user
def get_user(username):
if username in users:
return {"username": username}
return None

auth.init_app(app)

@app.get("/admin")
@auth.login_required
def admin():
return render_template("secret.html")

if __name__ == "__main__":
app.run()

初次访问/admin路由时服务器返回WWW-Authenticate: Digest realm="secret-path", nonce="MjQ5ODkxODU0Nw.aqgMag.Bbxymw21v8cFvF1T9REueRbsi_w", opaque="Mjk0NDc5Njc1Nw.aqgMag.PL6QtVO2qRimpCSEwdMxEuRSdng", qop="auth,auth-int"。

用户输入对应的密码后,浏览器在Authorization Header放Authorization: Digest username="admin", realm="secret-path", nonce="MzU2MjU1MzAw.aqgL2A.ceyzaVy7zEo1z5Xde9BtRoEz1iI", uri="/admin", response="aee55ad787a9c950b831ddfe9df88cdf", opaque="MTQwNzgzODUxOA.aqgL2A.wP4E08IN0BzYKQqrgSoxG26Yihg", qop=auth, nc=0000000f, cnonce="cda1b7777dcd4e90",用户就能访问到受保护的路由了。(这两次请求的nonce不一样,每次请求都会生成一个随机的nonce,后面计算的时候需要用浏览器这一段的信息)

参数比刚才的Basic Auth多多了,我们看一下发生了什么。

WWW-Authenticate头部中各字段的作用:

名称作用
nonce服务端生成的随机唯一字符串
opaque服务端指定的字符串,客户端需要原封不动返回
stale标志,指示由于nonce值过时而拒绝了来自客户端的上一个请求
algorithm哈希算法,SHA256、MD5等
qop必填,值auth表示身份验证,值auth-int表示具有完整性保护的身份验证
charset字符集
userhash标志,指示服务端是否支持用户名哈希

Authorization头部各字段的作用:

名称作用
response按照规则计算出的十六进制数字串(hex)
username用户名
realm略
uri请求的uri
qop指示客户端采用的qop
cnonce客户端提供的字符串
nc必填,nonce count,防重放
userhash指示用户名是否被哈希

response 的计算规则

response=KD(H(A1),  nonce:nc:cnonce:qop:H(A2))\text{response} = \text{KD}\Big( H(A_1),\; \text{nonce} : \text{nc} : \text{cnonce} : \text{qop} : H(A_2) \Big)

H():哈希函数,如 MD5、SHA-256

KD():密钥派生函数,本质是 H(secret, data)

对于普通算法来说,

A1=username:realm:passwdA_1 = \text{username} : \text{realm} : \text{passwd}

对于会话算法(-sess),

A1=H(username:realm:passwd):nonce:cnonceA_1 = H(\text{username} : \text{realm} : \text{passwd}) : \text{nonce} : \text{cnonce}

当 qop = auth 或未指定:

A2=Method:request-uriA_2 = \text{Method} : \text{request-uri}

当 qop = auth-int:

A2=Method:request-uri:H(entity-body)A_2 = \text{Method} : \text{request-uri} : H(\text{entity-body})

用户名哈希

username=H(username:realm)\text{username} = H(\text{username} : \text{realm})

我们用这种方法计算一下刚才试验的结果。

名称值
realmsecret-path
nonceMzU2MjU1MzAw.aqgL2A.ceyzaVy7zEo1z5Xde9BtRoEz1iI
cnoncecda1b7777dcd4e90
opaqueMjk0NDc5Njc1Nw.aqgMag.PL6QtVO2qRimpCSEwdMxEuRSdng
usernameadmin
password123456
uri/admin
qopauth
algorithm没有指定,默认MD5
methodGET
nc0000000f
A1=admin:secret−path:123456A2=GET:/adminA_1 = admin : secret-path : 123456 \\ A_2 = GET : /admin \\

A1哈希得到05a6b7c3154d30026f5009344ec192ab,A2哈希得到0b039339067eeaeff93a7d25514492d1。

response = H(05a6b7c3154d30026f5009344ec192ab:MzU2MjU1MzAw.aqgL2A.ceyzaVy7zEo1z5Xde9BtRoEz1iI:0000000f:cda1b7777dcd4e90:auth:0b039339067eeaeff93a7d25514492d1),得到aee55ad787a9c950b831ddfe9df88cdf,跟刚才试验的结果相同。

对于服务器来说应该怎么验证response呢?客户端明文给服务端传了用户名,服务端里存储着用户名对应的密码,只要在服务端这里再进行一次哈希,比对一下两次哈希是否相同即可。

在Postman中对请求进行重放,发现服务器不认。注意直接在浏览器重放没用,因为服务器在浏览器验证成功后存了一个session cookie。

Cookie是以键值对形式存储在浏览器的一些短文本。但cookie可以被轻易查看和修改,如果将一些重要的东西以明文形式存在cookie中,不亚于直接将钥匙给小偷。CTF Web也只有教新手查看cookie的题目会这么出。

但如果服务器将一些信息存在服务器本地(session),然后提供了一个标识字符串给浏览器(cookie),服务器可以通过访客的cookie识别到对应的信息,信息对访客来说一般是不可读的(二般情况我们等会讲),避免了查看和篡改的风险。

session-cookie

下面看用flask构建一个简单的服务。

from flask import Flask, session, redirect, url_for, request

app = Flask(__name__)
app.secret_key = "change-me"

@app.route("/")
def index():
if "username" in session:
return f"""
<h1>欢迎回来,{session["username"]}!</h1>
"""
return "<h1>请登录</h1>"

@app.route("/login", methods=["GET", "POST"])
def login():
if request.method == "POST":
username = request.form.get("username", "")
if username:
session["username"] = username
return redirect(url_for("index"))

return """
<form method="post">
<input type="text" name="username">
<input type="submit" value="登录">
</form>
"""

登录之后会发现多了一个名为session的cookie,值为eyJ1c2VybmFtZSI6ImFkbWluIiwidmlzaXRzIjowfQ.aqlKYw.uJksUqvQTxa_pmVIkBDyTe9AqQ8。此前有接触过类似东西的小伙伴可能会觉得这是jwt,实则并非。我们可以在Flask Session Cookie Decoder中读出session包含的内容。比如我们这个session的内容是:

{
"username": "admin",
"visits": 0
}

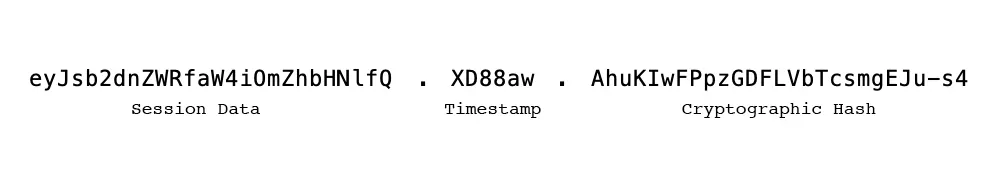
Flask session由三个部分组成,分别是数据、时间戳和签名组成,数据实际上是可读的,但不好篡改,因为有secret key。2服务器用相同的方式生成一个session比对后就能发现是否被篡改。这点跟后面的jwt有些相似,这样服务器就不用再维护一个数据库来存储一堆随机的cookie与它们的session的对应关系了。

flask-session-body

但如果这个secret key够弱(比如我们文中的这个),就可以用弱口令词典去爆破。

PS C:\> flask-unsign --unsign --cookie "eyJ1c2VybmFtZSI6ImFkbWluIiwidmlzaXRzIjowfQ.aqlKYw.uJksUqvQTxa_pmVIkBDyTe9AqQ8"
[*] Session decodes to: {'username': 'admin', 'visits': 0}
[*] No wordlist selected, falling back to default wordlist..
[*] Starting brute-forcer with 8 threads..
[+] Found secret key after 42240 attempts
'change-me'

得到secret key之后就可以随意伪造session了。除了用flask-unsign之外,还可以自己搭一个flask去签发假session,也可以用脚本签发。

from flask.sessions import SecureCookieSessionInterface
from itsdangerous import URLSafeTimedSerializer

class S(SecureCookieSessionInterface):
def get_signing_serializer(self, secret_key):
return URLSafeTimedSerializer(
secret_key,
salt=self.salt,
serializer=self.serializer,
signer_kwargs=dict(
key_derivation=self.key_derivation,
digest_method=self.digest_method,
),
)

serializer = S().get_signing_serializer('change-me')
fake_cookie = serializer.dumps({'username': 'admin', 'visits': 999})
print(fake_cookie)

Flask也有其他session相关的库,比如flask-session,它提供了一种server-side session,也就是session的内容存储在服务器上。对应的有client-side session,也就是我们刚才见识的flask默认的session。

我们可以用这个代码来看看server-side session。

from flask import Flask, session
from flask_session import Session

app = Flask(__name__)
# Check Configuration section for more details
SESSION_TYPE = 'filesystem'
app.config.from_object(__name__)
Session(app)

@app.route('/set/')
def set():
session['key'] = 'admin'
return 'ok'

@app.route('/get/')
def get():
return session.get('key', 'not set')

if __name__ == "__main__":
app.run()

浏览器先访问/set/,再访问/get,名为session的cookie值为FGN9IPiXxrCrjRLy5uPCMru-Y8zOxnHMfuipu9hSFtU。这个字符串就不太能读了。我们发现在我们的代码目录下多出了一个名为flask_session的文件夹,session的信息就存储在里面。感觉里面存储了序列化的东西,可以用下面这个脚本大致读出来{'_permanent': True, 'key': 'admin'},但在此之前还存了一些字符,究竟是什么意思,具体机制有待探究。

import pickle

with open('./f98473cdd5c467387ed7280ce6be805d', 'rb') as f:
data = f.read()

obj = pickle.loads(data[15:])
print(obj)

Session Cookie这种验证方式不防重放,如果被窃取到了攻击者就可以原封不动地用session伪装用户进行操作。要防重放的话就要用其他手段(比如多加一个nonce等等)。对于client-side session来说保护内容不被篡改其实就是保证有一个强的secret key,而server-side session则没有篡改的问题。

当然server-side session虽然不存在secret key导致的问题,但面临着会话劫持攻击的风险。尽管目前成熟应用的sessionid都很复杂,难以预测和暴力破解,但需要采取措施防范攻击者窃取sessionid。这一点在本文上下都有提到。

Bearer Token​

这个验证本身非常简单,很多服务都在用,就是在Authorization头里面加服务器给的token就可以了。

Authorization: Bearer <token>

对于服务器来说一般需要维护一个token的数据表,跟server-side session差不多。本身不防重放,需要使用HTTPS等手段保护token。

这个鉴权机制本身非常简单,但如何保护token,防护攻击需要一些策略。

首先,最基础的就是HTTPS,没有它一方面数据会像前面提及的那样裸奔,用它来抵御中间人攻击等。

其次,token本身不能直接放在cookie里,因为如果用户被诱骗访问https://example.com/buy之类的接口,浏览器会自动发送cookie内容,完成鉴权,在不经意间完成敏感操作。这就是跨站请求伪造(CSRF)攻击。

那么,token应该存哪呢?token应该作为返回值,由前端存到localStorage中。这样浏览器在访问链接时并不会主动发送token,而是由前端将token放到接口请求的Authorization头部。

但即便这样,恶意的js脚本还是能访问到localStorage,面临xss攻击的问题,可以交由Content-Security-Policy和前后端的过滤机制来防范。

JWT​

前面Bearer Token一般是不可读的,前端收到服务器发过来的token不知道这个字符串代表着什么意思,如果要获取用户信息的话还需要向类似auth/me之类的接口获取数据。有没有既能鉴权,又能包含用户信息的呢?

你可能想到前面的client-side session。除了这个,还可以用JWT(JSON Web Token)。

在介绍JWT之前,讲一个场景。拿server-side session举例子,服务器先将用户的id等信息存到session中,并将session-id存到cookie,后续用户发送携带session-id的请求,服务器再到session中查找信息。这个场景对单点服务没有问题,但如果后端是一个服务器集群呢?上游的cdn会将请求发送到其中一个节点,此时很有可能会出现session不在该节点的问题,用户的鉴权态就无效了。

要解决这个问题,session就不能存储在节点自己的内存中了,可以存储到统一的数据库中。但每次验证都要从数据库中取信息,多了来回的耗时,压力也给到数据库这里。而且数据库一旦挂了,所有需要鉴权的服务统统都挂了。

另一种方案是服务器索性不保存session了,所有数据都保存在客户端,每次请求都发回服务器。这就是JWT。

JWT由三个部分构成,头部(Header)、载荷(Payload)和签名(Signature),每个部分用.分隔。

下面用PyJWT库生成json web token。

import jwt

payload = {"username": "admin"}
secret = "secret"
encoded_jwt = jwt.encode(payload, secret, algorithm="HS256")
print(encoded_jwt)

运行得到eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec,可以在JWT 解析工具查看这个字符串每个部分的含义。

header部分描述jwt的元数据,alg为jwt签名用的算法(默认为HMAC SHA256),typ为JWT:

{
"alg": "HS256",
"typ": "JWT"
}

body也是一个json对象,要使用Base64URL算法转成字符串,官方提供了一些字段供选用:

  • iss (issuer):签发人
  • exp (expiration time):过期时间
  • sub (subject):主题
  • aud (audience):受众
  • nbf (Not Before):生效时间
  • iat (Issued At):签发时间
  • jti (JWT ID):编号

可以用相同的库进行jwt的解析,当密钥不相同时会抛出jwt.exceptions.InvalidSignatureError异常。

secret = "fakesecret"
decoded_jwt = jwt.decode(encoded_jwt, secret, algorithms="HS256")
print(decoded_jwt)

签发jwt同样需要一个强密钥,不然会被暴力破解。这里尝试用字符集进行暴力破解,用时比较长,用弱密码字典会更快,比如说用rockyou字典77ms就出来了。

./jwt_tool.exe brute -token "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec" -minLen 4 -maxLen 10 -charset "qwertyuiopasdfghjklzxcvbnm" -threads 0
尝试次数: 143933669 当前密钥: sescms
成功破解密钥!密钥为: secret
总尝试次数: 144096418, 耗时: 4m7.4560252s
./jwt_tool.exe crack -token "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec" -dict ".\rockyou-65.txt"
成功破解密钥!密钥为: secret
Measure-Command { ./jwt_tool.exe crack -token "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec" -dict ".\rockyou-65.txt" }

Milliseconds : 77
Ticks : 770263
TotalMilliseconds : 77.0263

除此之外,jwt payload并没有加密,所以不能把一些敏感信息放到jwt中。

jwt在应用的过程中有很多漏洞,比如alg=none和加密算法混淆等,对应的也有很多的利用方法。可以阅读Burpsuite靶场-JWT漏洞原理总结及复现这篇文章了解。

对此,我问了一下在研究攻防的CopperKoi同学。他补充了JWT在攻防中主要就是跨站、爆破和伪造。

在session cookie中,我们想要吊销某个session非常容易,在服务器中将session标记为删除(不物理删除,便于审计)即可。但JWT并没有这种机制。如果将JWT存进数据库,维护状态的话,那跟session cookie除了可读性之外就没差别了。这篇文章提供了黑名单和白名单两种方法,黑名单就是将被吊销的JWT存进Redis之类的数据库中,每次校验JWT时查一下数据库。

TOTP​

认证因素分为这样几类:

  • 知识因素(Knowledge factors):用户所知内容,例:密码、PIN码、共享秘钥、与自身相关的信息
  • 持有因素(Possession factors):用户拥有的东西,比如身份证、护照、安全令牌或智能手机
  • 属性因素(Inherence factors):用户具备的特征,通常是生物识别技术,物理特征映射的个人属性,如指纹、面部、声音,还包括行为识别,例如说话方式、走路方式、打字方式识别。

TOTP作为双因素验证(2Fa)中比较常见的一种方法,可以通过验证用户的持有因素来提高安全性。

因为用户的持有因素可能丢失、失窃,所以TOTP一般不作为服务唯一的验证因素。

在开启TOTP时,服务器会先生成一个密钥。

import pyotp

secret_key = pyotp.random_base32()
print(secret_key)

随后会向前端返回一个链接,label是用户的名字,secret是上面经过Base32编码后的密钥,issuer代表应用名。

totp = pyotp.TOTP(secret_key)
uri = totp.provisioning_uri(name="admin", issuer_name="totp test")
print(uri) # otpauth://totp/{label}?secret={secret}&issuer={issuer}

前端将链接转换为二维码供用户扫描,用户将这个链接的信息添加到设备的TOTP生成器上。用户再次登录时,后端可以计算用户的TOTP,并将两者进行比对。

user_code = input()
if totp.verify(user_code):
print("Valid")
else:
print("Invalid")

TOTP本身貌似没有什么值得提的攻击方式。有的就是30秒内TOTP可以重用(CVE-2025-6014、CVE-2026-57574)这种有些局限的漏洞,或者加密算法可预测这些。

OAuth / OpenID Connect(OIDC)​

认证(authentication)和授权(authorization)是两个不同的过程,认证负责认出“你是谁”,而授权负责找出“你能做什么”。前面我们提到的JWT、session cookie等常把认证和授权合并在一起(比如将权限信息写在JWT里等等),我们不需要严格区分。但到这里,我们需要区分这两个过程。

WebAuthn​

to be written

Reference​

Basic Auth:

Digest Auth:

Bearer Token:

Session Cookie:

JWT:

TOTP:

OAuth:

Footnotes​

  1. 参考WWW-Authenticate - HTTP | MDN ↩

  2. 国外有位大佬对flask session进行分析,并开发了flask-unsign这个在文中使用到的爆破工具,描述session内容的图片就来自他的博客,但博客现在没有办法访问了,可以去互联网档案馆阅读。 ↩

高考之后(贰)

· 阅读需 2 分钟
林林
在西安读大二的小菜鸡

西电礼仪广场

西安的天逐渐热了起来,太阳大,云少,空气都是热的。相比于福建的桑拿天,貌似这里的天气比较好。前段时间没了解过我们宿舍门口的小卖部有没有冰淇淋,于是常骑自行车去老综合楼的蜜雪冰城买圣代吃。前些天知道小卖部有卖方糕了,便开始每天吃一个方糕。

高三走读那年,四五月的下午也很热,去学校的路上几乎都会从同一家小卖部买个方糕吃。至于为何选方糕,甜筒融化之后会粘到手上,没卖圣代,三色杯那种还要一只手拿着一只手挖,就方糕省事不麻烦。高考考完之后,离开了学校,几乎没怎么在大热天出过门,就再没吃过。

不知对不对,人死前脑子会像走马灯一样过一遍所有瞬间。是当时看到成绩、看到录取结果时的欣喜,还是平日里的滋味,亦或是暴雨中的困顿与焦虑,更值得被回忆?高二的时候我给我的班主任画了一张图,三个圆圈交叉在一起,分别是作业完成质量高、睡眠充足和独立完成,两个圆圈交叉的地方分别写上“抄来的”、“乱写的”和“熬夜”,又在三个圆圈交叉的地方写了一个“滚”字。当时对我来说算是至暗时刻,如今想来当时的压力与挣扎都是过往云烟。有些事情原本以为放不下,过段时间就放下了;而有些事情当初以为能过去,至今过不去。

高考往后的三个月,刚毕业的高三学生将沉浸在对大学美好生活的向往当中,直到进入大学才逐渐破灭。

高考,是集体的狂欢,还是青春的眼泪?

「进行中」XDSec SSO开发小记

· 阅读需 4 分钟
林林
在西安读大二的小菜鸡

因为信安协会原本的SSO改用户信息比较麻烦,协会的周报系统和论坛两个系统打通的任务从很早以前咕到现在,重新开发一版SSO的任务就这样提上日程。这也算是我第二个项目?

谨以本篇文章记录我在整个项目设计、开发、测试和部署过程中的一些经验。能将协会各位大佬传授的经验记录沉淀下来,算是我的一份荣幸。

因为这个项目的周期可能比较长,就先发,随时更新。

如何防止邮箱枚举​

我们系统有一些端点需要对外暴露,既要让用户使用,也要防止邮箱枚举造成信息泄露。大概有这些接口:

  • 通过用户名登录
  • 通过邮箱重置密码

我们在设计的过程中,明确不允许用户自主注册账户,只能通过管理员在后台添加或导入,所以「注册用户」这个接口不列在这里。

「通过用户名登录」这个接口可以很容易想到「用户名或密码错误」的提示信息来规避明确告知用户名不存在,但「通过邮箱重置密码」这个如果提示邮箱错了就直接表明邮箱不存在,告知邮箱存在容易误导用户。直到我问了Deepseek,它说了一句「如果该邮箱已注册,验证码已发送至邮箱」。这句话点醒了我,怎么会有这么美妙的设计。

后来,为了对开启TOTP的用户进行验证,我们又设计了一个接口,输入邮箱,返回该用户是否开启TOTP。这个也容易泄露邮箱,我想到了一招:

  • 当邮箱存在时,返回真实的信息;
  • 当邮箱不存在时,不报错,从true和false里随机返回一个。

这样攻击者就区分不出哪些邮箱有账户,哪些没有了。当然这样设计TOTP的验证流程在大佬眼中欠佳,他给出了更好的解决方案。

如何利用jwt并设计TOTP验证流程​

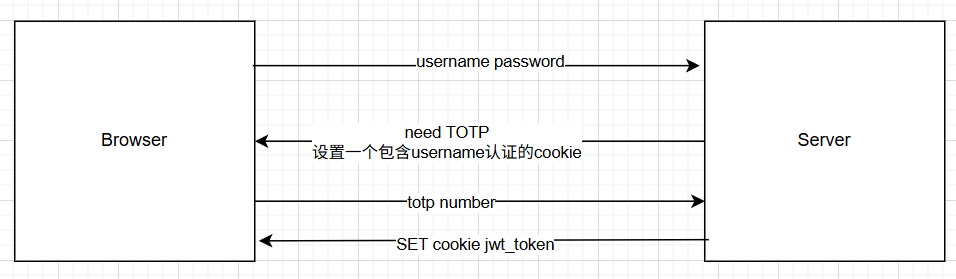
我之前在设计TOTP验证流程的时候注意过,腾讯云和Cloudflare的登录验证都是单独腾出一个页面来弄。尝试看看他们怎么处理这个流程的,可惜我网页逆向水平太差,看不懂,只能从网络Tab里捕风捉影。大概猜了一个这个。

但是感觉这样还要生成一个token给前端太麻烦了,于是改了一下——让前端先看看需不需要TOTP,再把TOTP、用户名、密码一块返回给后端,也就是上一节的那个接口对应的方案。

emmmm
很有想法(
不过让我设计的话我可能先正常登录之后重新开个页面说totp的事

Reverier对这份方案的评价

看来他倾向于另开一个页面的方案,为什么呢?

因为用户登录接口本身是有密码鉴权这个慢哈希接口来做限流的,而且登录接口本身风控比较严。你这么设计相当于开放了一个非登录鉴权的api出去,并且这个api还会查库,攻击者如果只是想把你网站弄垮的话,可以dos这个api给你数据库压力打满,而且因为没有登录态,你还追不到来源。

然后他分享了一个非常美的设计。

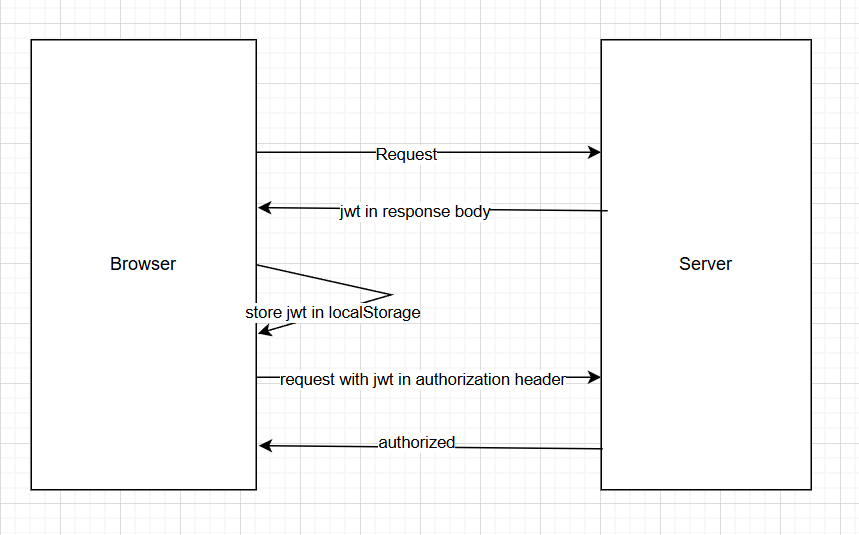
jwt不应该存在cookie里,这样前端拿不到,应该作为接口返回值给前端存本地存储里

可以把totp登录态直接放在jwt字段里。这样前端拿到jwt一解,发现totp未登录,就继续要求totp验证。验证之后,服务器重新签发一个totp已登录的jwt。两套系统就合一起了,不用维护两拨token。服务端解码jwt发现totp开启并且未登录的时候直接视为整个未登录就好了。

这个设计实在优雅,把两套token合在一起,还让totp的验证流程更简洁了。

试驳友谊之传递链

· 阅读需 4 分钟
林林
在西安读大二的小菜鸡

每当我遇到生活上的困惑时,我都会打开《人生哲思录》看看周先生写过的文字。之前几次对朋友感到困惑,于是几次翻开这本书。如今,朋友这个词再一次让我感到困惑,我也就再翻起这本书。

我问:“你认为网络上的友谊应该有传递链吗?比如说如果我知道一个人和我讨厌的人在一起,我对这个人的信任值就会降低。”他答:“我也这样。”

我其实对这种传递链并不感冒。“朋友的朋友是我的朋友,敌人的朋友是我的敌人。”这句话实际上并没有什么道理。将既是朋友也是敌人的冲突按下不表,这种方法把人几乎分成了两类,一类是某个人的朋友,或者朋友的朋友,另一类是某个人的敌人,或者敌人的朋友,又或者朋友的敌人。一个人要是遵循这种原则交友,找的朋友基本就在一个“朋友圈”里面,一个人的朋友的朋友是一个人的朋友,也是圈子里其他人的朋友。在这样的圈子当中,发言、表达情绪都要格外慎重。如果圈子里的人都遵循友谊的传递链原则,那么若是因为口角之类的事情跟一个曾经的朋友关系不好,这种关系不好的状态会顺着友情的网络传递下去,直到被整个圈子驱逐为止。

再论先前按下不表的冲突,一个人既可以是某个人的敌人,也可以是另一个人的朋友,若他既是我某个朋友的朋友,又是我某个敌人的朋友,那么根据传递链,我能否与他做朋友?一个人与另一个人是否是朋友这个二元关系非常复杂,而且根据我们实际的生活经历知道这个二元关系不满足传递性,换句话说“是否是朋友”不是一个传递闭包。我们可以用代码举一个例子,尽管单单用代码证明不了这件事。

a = {"like": [1, 2, 3], "is": 1}
b = {"like": [1, 3, 4], "is": 3}
c = {"like": [3, 4, 5], "is": 4}

print(a["is"] in b["like"] and b["is"] in a["like"]) # True a和b是朋友
print(b["is"] in c["like"] and c["is"] in b["like"]) # True b和c是朋友
print(a["is"] in c["like"] and c["is"] in a["like"]) # False a和c不是朋友

那么为什么这种传递链会存在呢?我看,是因为“朋友圈”。如果我被朋友发现我跟他们讨厌的人来往,我在他们眼里就成了“不忠”。我也可以用同样的方法识别出那些对我忠诚的朋友。照此,朋友圈变成等级森严的组织,一个人在圈子里就像拴上绳子的狗,限定与圈子里的狗交往。传递链也是一种省事的方式,但它真的用起来其实并不省事。传递链实质上将择友的权利让渡给我的朋友们,他们的眼光也就是我的眼光。很荒谬,这就是问题所在。

朋友圈应该是流动的,仅仅只是我的朋友组成的一个概念。我有独立判断的权利,是否与一个人做朋友应该取决于我们之间有没有默契和互相欣赏,而不是他属于哪个圈子里。一个人不应该被困在圈子里。若是从一个圈子里跳出来,对一个圈子怯魅,那他还可能会跳进别的圈子,然后对别的圈子怯魅。他其实只是对特定的某个圈子怯魅,没有真正跳出圈子这个体系,往后要么找到让他安心的圈子,要么在圈子之间跳来跳去。他会找到让他安心的圈子吗?会有圈子让人安心吗?

圈子不好玩,圈子里的人有的需要崇拜,有的需要归属和认同,大家都只是得到自己想要的东西。进圈子简单,给自己贴上标签即可。人喜欢给自己贴标签,说是让自己更了解自己,也让别人更了解自己。贴标签不是什么没有代价的事情,贴完之后便从立体的人坍缩成标签化的人。

“他在朋友圈挂我了,他那群朋友会怎么想?会怎么看我?”传递链找不来真朋友,圈子也不解放人。